CSV o Excel para diagramas de flujo: desde qué archivo construir
Un CSV es una sola tabla de texto plano, sin fórmulas, sin segunda hoja y sin formato. Excel tiene las tres cosas y rara vez es lo que exporta un sistema. Desde qué formato construir un diagrama de flujo y qué te cuesta cada uno.
Excel es el mejor sitio para preparar un proceso a mano; el CSV suele ser el archivo que un sistema te entrega de verdad. Los dos se convierten en diagrama de flujo, pero fallan en sitios distintos, y saber cuál tienes decide qué compruebas primero.
En resumen
- El CSV es una tabla de texto plano: sin fórmulas, sin segunda hoja, sin formato, sin nada que recalcular.
- El CSV no declara su delimitador. Coma, punto y coma y tabulador están todos en circulación y el archivo se ve igual.
- Los ceros a la izquierda sobreviven en el archivo y mueren en el visor: 00742 está intacto hasta que Excel abre el CSV y lo vuelve a guardar.
- Excel conserva tipos y fórmulas, pero una fórmula ya es un valor cuando es una caja, y el .xlsx rara vez es lo que exporta un sistema.
- Los dos se importan igual: suelta el archivo sobre el área de la hoja de cálculo o pega las filas dentro, y el emparejamiento es por nombres de encabezado y no por orden de columna.
Qué puede llevar cada formato y qué no
Los dos formatos no son dos versiones de la misma cosa. Un CSV es un archivo de texto: una tabla, una fila por línea, campos separados por un delimitador, comillas alrededor de todo campo que lleve ese delimitador. Dentro no hay nada más: ni fórmulas, ni tipos de celda, ni una segunda pestaña, ni color, ni anchos de columna. Un .xlsx es un paquete comprimido de XML que lleva todo eso, y por eso es el mejor sitio para redactar un proceso a mano y por eso casi ningún sistema emite uno. Pídele tus datos de proceso a un ERP, a un PIM, a una herramienta de tickets o a una base de datos y lo que vuelve es un .csv.
Un diagrama de flujo necesita menos de lo que ofrece cualquiera de los dos formatos. Una fila por caja, una etiqueta, los números de fila a los que se conecta cada fila, las etiquetas de conector en el orden correspondiente y, opcionalmente, una forma y dos columnas de carril. Ese es el requisito entero, y todo él es texto. Todo lo que Excel añade por encima hay que resolverlo a un valor antes de que pueda convertirse en una caja de todas formas: una fórmula se convierte en el número que produjo, una búsqueda contra una segunda hoja se convierte en la cadena que devolvió, un formato condicional no se convierte en nada. Si quieres ese requisito completo, /es/guides/como-estructurar-un-csv-para-diagramas-de-flujo enumera las columnas; esta página va solo del contenedor.
Así que la comparación honesta es sobre lo que te cuesta cada contenedor. El CSV te cuesta un delimitador que el archivo no declara nunca (coma en Estados Unidos, punto y coma en casi toda Europa, tabulador con la frecuencia suficiente como para importar), más una codificación que solo a veces es UTF-8 y a veces lleva una marca de orden de bytes delante del primer nombre de encabezado. No tiene tipos, así que un código de producto y una cantidad se ven idénticos, y en cuanto Excel abre el archivo adivina: 00742 se convierte en 742, 3-4 se convierte en una fecha, un SKU largo se convierte en notación científica. Excel te cuesta el conjunto contrario. Es un binario que no puedes comparar ni buscar con herramientas de texto, invita a celdas combinadas, a un encabezado de dos filas y al color usado como dato, y el archivo que te dan no suele ser el que produjo el sistema: alguien abrió la exportación y la guardó, que es donde ocurre casi todo el daño de un CSV.
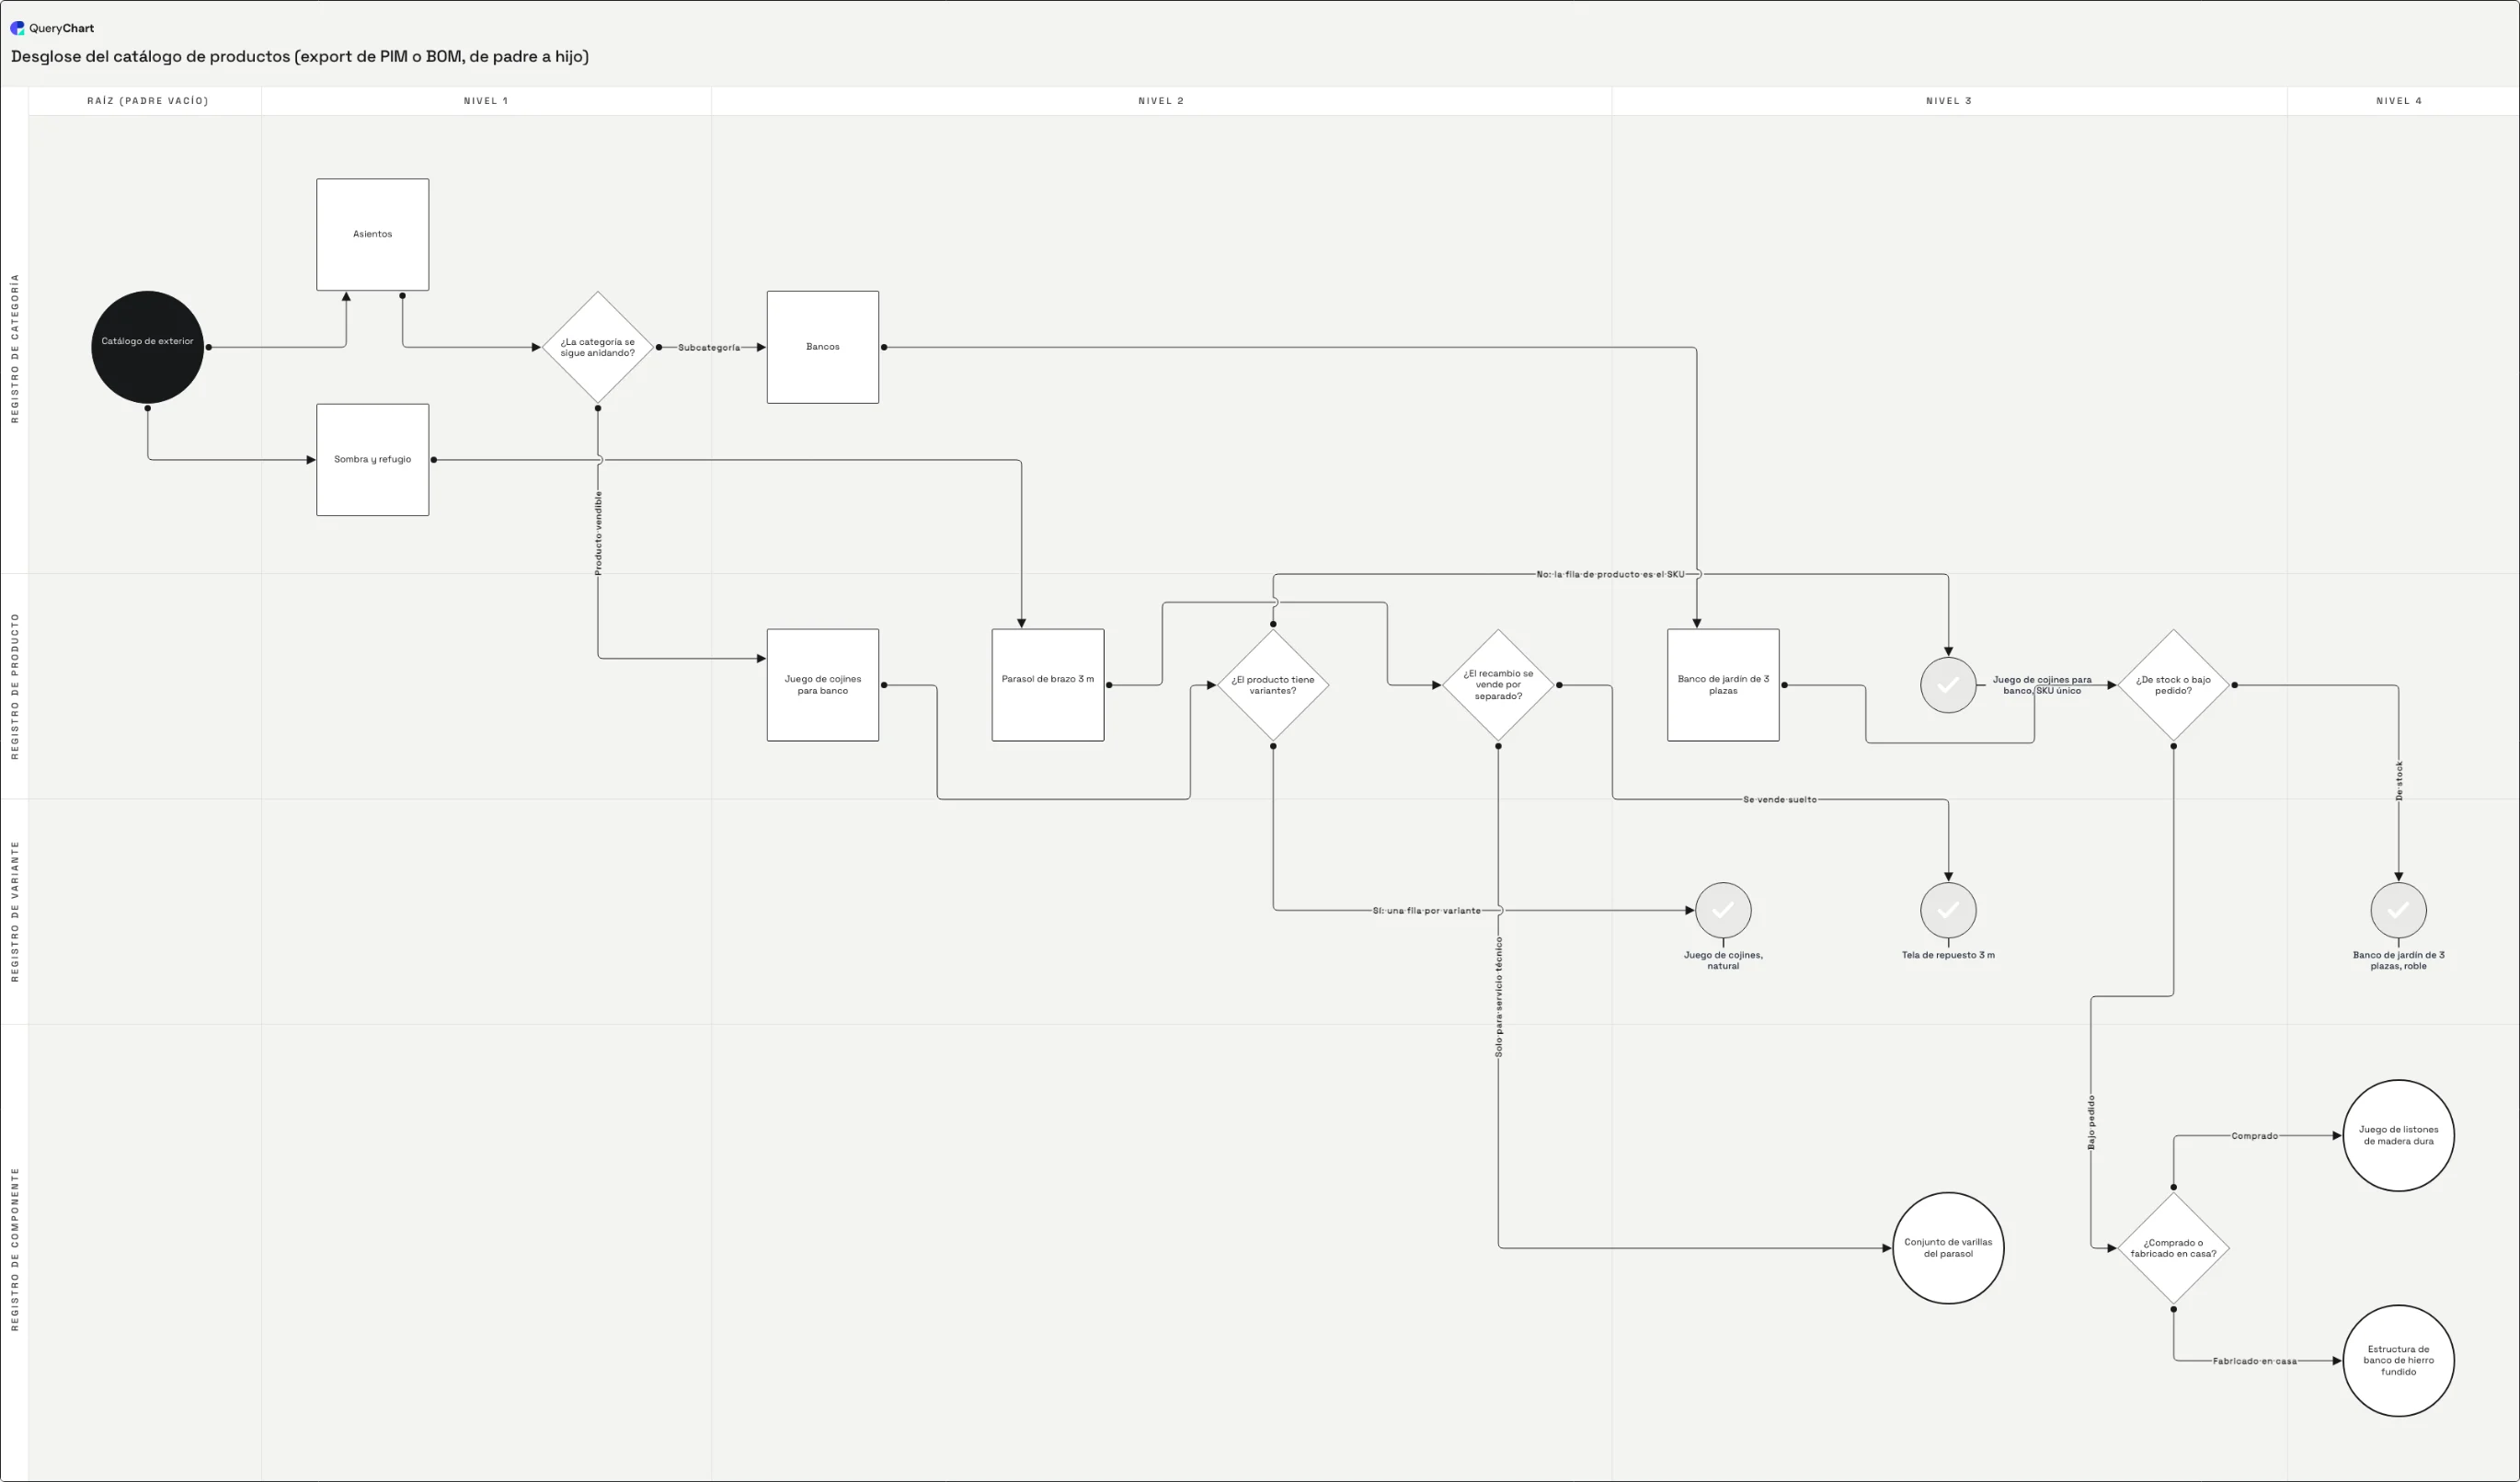
El ejemplo de abajo es un desglose de catálogo de productos, la clase de exportación de padres e hijos que solo llega en CSV. Diecinueve filas, una raíz cuya celda de padre está vacía, cinco decisiones donde un catálogo se bifurca de verdad, siete hojas. Mira cómo el recorrido rellena una columna cada vez y fíjate en qué fases habrían sido más fáciles en Excel y en cuáles no habría habido ninguna diferencia; la plantilla en sí está en /es/templates/csv-a-jerarquia-padre-hijo.
Una exportación CSV convirtiéndose en diagrama, una columna cada vez
Una exportación de catálogo de productos en cuatro grados de completitud. Abre el panel de la hoja de cálculo para ver qué columna rellena cada fase.
Lo que te da la exportación
Una exportación de PIM llega como nombres y una columna de tipo, no como flechas. Las cuatro primeras filas de aquí son «Catálogo de exterior», «Asientos», «Sombra y refugio» y la pregunta «¿La categoría se sigue anidando?». Solo está rellena Forma, y Forma es la única columna que un CSV suele implicar ya a través de su campo de tipo o de nivel: esta fase no te cuesta nada en ninguno de los dos formatos.
Invertir la columna de padre en Línea a
La exportación decía el padre de cada fila; Línea a dice los hijos de cada fila, como números de fila. «Catálogo de exterior» guarda ahora «2,3» y aparecen las flechas. Esta es la única fase que Excel habría acortado de verdad, porque resolver un código de padre a un número de fila es una búsqueda; y es también la fase en la que un archivo delimitado por comas necesita esa celda envuelta en comillas dobles o la fila gana un campo.
Etiquetar las ramas en Texto de línea
«¿El producto tiene variantes?» toma «Sí: una fila por variante» y «No: la fila de producto es el SKU», emparejadas por posición con sus dos números de Línea a, 11 y 12. Fíjate en los dos puntos. Una coma dentro de una etiqueta de rama no es un problema de comillas que puedas resolver: Texto de línea se parte por las comas después de que las comillas del CSV se hayan quitado, así que una etiqueta que lleve una se convierte en dos etiquetas y el emparejamiento con Línea a se desplaza. Excel tampoco te avisará de esto: es una propiedad de la columna y no del formato de archivo.
Añadir las columnas de carril
Carril horizontal guarda la profundidad recorrida por la cadena de padres, de Raíz (padre vacío) a Nivel 4, y Carril vertical guarda la propia columna de tipo de la exportación: registro de categoría, de producto, de variante y de componente. El tipo ya estaba en el archivo y la profundidad había que derivarla, que es la división entera en miniatura: el dato que te dio el sistema frente al dato que calculas tú. Después de la importación no queda nada que recalcular, así que la ventaja deja de importar.
Cómo funciona
Averigua qué archivo tienes en realidad
Si el proceso salió de un sistema, tienes un CSV diga lo que diga el icono, y lo más prudente que puedes hacer con él es no abrirlo en Excel. Si alguien escribió el proceso a mano, tienes un libro, y llevará celdas combinadas dentro. Los dos puntos de partida piden primeros movimientos distintos, y tratar una exportación como si fuera un libro es lo que mete fechas en tus códigos de producto.
Abre el CSV en un editor de texto antes que en una hoja de cálculo
Mira las dos primeras líneas. Te dicen el delimitador, si los campos van entrecomillados, y si el primer nombre de encabezado lleva delante tres bytes invisibles de una marca de orden de bytes UTF-8. Treinta segundos aquí te ahorran los dos fallos que parecen errores de software y no lo son: un archivo que se importa como una única columna enorme, y una primera columna que se ignora en silencio porque su encabezado ya no coincide.
Si tu origen es Excel, aplánalo a una sola tabla
Pega la hoja sobre sí misma como valores para que cada fórmula se convierta en la cadena que produjo. Descombina todo, borra el bloque de título de encima del encabezado, borra las filas en blanco de separación y mueve a una columna de verdad todo lo que estuviera codificado como color de relleno o como negrita, porque nada de eso sobrevive al viaje. Una fila de encabezado, una fila por paso, una hoja. Un CSV es una tabla por definición, así que este es el paso que iguala los dos orígenes.
Añade las columnas de conexión como números de fila
Línea a guarda el número en base 1 de la fila a la que se conecta cada fila, separado por comas cuando hay más de una, y Texto de línea guarda las etiquetas de conector en ese mismo orden. En un archivo delimitado por comas las dos celdas tienen que ir entrecomilladas («5,6» y «Sí,No») o la fila acaba con un campo más que el encabezado y todas las columnas posteriores se desplazan a la izquierda. Este es el único dato genuinamente nuevo que tienes que aportar en cualquiera de los dos formatos.
Impórtalo
Suelta el .csv sobre el área de la hoja de cálculo del editor, o pega dentro el texto del CSV. Las columnas se emparejan por nombre de encabezado, así que su orden en tu archivo da igual y todo lo que no se reconozca viaja y se ignora. Desde un libro, o seleccionas el rango y lo pegas dentro, o guardas antes la hoja como CSV: lo segundo merece la pena cuando la hoja lleva algo raro, porque guardar como CSV te enseña qué sobrevive de verdad.
Comprueba las tres cosas que solo se rompen en un sentido
Códigos que perdieron un cero a la izquierda, valores que se convirtieron en fechas, y una columna que se desplazó en algún punto en mitad del archivo. Las tres vienen de que algo adivinó al analizar un CSV, y las tres son invisibles hasta que las buscas. Arréglalas en las filas y no en la exportación original, porque a partir de este punto el maestro es el diagrama y el archivo es una foto.
Errores que debes evitar
Abrir la exportación en Excel «para revisarla»
Excel analiza al abrir y guarda lo que analizó. 00742 vuelve como 742, 3-4 vuelve como una fecha, un código de dieciséis dígitos vuelve en notación científica, y los valores originales ya no están en el archivo. Si tienes que mirarlo, míralo en un editor de texto o impórtalo como texto.
Dar por hecho que el delimitador es una coma
La mayoría de las exportaciones europeas de sistemas van delimitadas por punto y coma, y un archivo delimitado por tabuladores llega a menudo con nombre .csv. Nada dentro del archivo declara cuál es. Que una exportación entera caiga en una sola columna significa que el delimitador se adivinó mal, no que el archivo esté roto.
Significado llevado por el formato
Negrita para las decisiones, amarillo para la vía de excepción, una celda combinada abarcando una fase. Esta es una costumbre exclusiva de Excel y el CSV la borra entera sin avisar. Todo lo que lleve significado tiene que ser una columna (Forma, Texto de línea o un carril) antes de exportar el archivo.
Exportar la hoja equivocada
Un libro guarda los pasos en una pestaña y la lista de responsables o la tabla de códigos en otra, y el CSV se lleva una tabla. Resuelve primero las búsquedas a valores y exporta después la pestaña con los pasos. /es/guides/como-definir-las-conexiones-de-un-diagrama-de-flujo-en-csv cubre qué necesitan las columnas de conexión una vez que estás con una sola tabla.
Importa tu CSV como diagrama de flujo
Abre el ejemplo del catálogo como tu propio diagrama para ver las columnas rellenadas, y pega después encima tu propia exportación.
Guías relacionadas
Preguntas frecuentes
¿Exporto CSV o XLSX para hacer un diagrama de flujo?
Coge lo que el sistema de origen ya produzca, que en la práctica significa CSV. Convertir una exportación a un libro añade un paso de análisis que solo puede perder información, y las funciones del libro que ganarías (fórmulas, tipos, una segunda hoja) son todas cosas que hay que resolver a valores planos antes de que una fila pueda ser una caja. Excel es mejor opción en un caso: cuando el proceso no existe todavía en ningún sitio y lo estás escribiendo a mano, porque una fórmula que convierte un código de paso en un número de fila es genuinamente más rápida que hacerlo a mano. Ese camino está en /es/guides/crear-diagrama-de-flujo-desde-excel. Una vez fijadas las filas, los dos formatos convergen por completo.
¿Pierde el CSV algo que un diagrama de flujo necesite de verdad?
No. Todas las columnas con las que se construye un diagrama son texto: la etiqueta, los números de fila de Línea a, las etiquetas de conector de Texto de línea, el nombre de la forma y los dos nombres de carril. Nada de eso necesita un tipo, una fórmula ni una segunda hoja, así que un CSV lleva un diagrama de flujo completo sin que falte nada. Lo que el CSV pierde es todo lo que rodea al diagrama: el formato, las notas de un comentario, la tabla dinámica de la pestaña siguiente, la columna que se calculaba en lugar de guardarse. Si algo de eso es estructural para tu proceso, era significado codificado fuera del dato, y tiene que convertirse en una columna antes de exportar y no después.
¿Por qué cambiaron mis códigos de producto al abrir el archivo?
Porque un CSV no tiene tipos y el programa que lo abrió tuvo que adivinar. Un campo que dice 00742 son solo esos cinco caracteres dentro del archivo; Excel lo lee como un número, se come los ceros a la izquierda y muestra 742, y si guardas en ese punto el propio archivo dice ya 742. Esa misma suposición convierte 3-4 en una fecha, convierte un código numérico largo en notación científica, y reinterpreta 01/02 según la configuración regional de quien lo abrió. El archivo era correcto hasta que se miró. Importa el CSV directamente en lugar de hacerlo pasar por una hoja de cálculo, o si tienes que abrirlo, importa las columnas como texto.
¿Qué formato es mejor cuando varias personas mantienen el proceso?
El CSV, mientras el proceso viva en un archivo. Es texto plano, así que se compara línea a línea, se busca, se fusiona y se guarda en control de versiones enseñando exactamente qué pasos cambiaron entre dos revisiones. Un .xlsx es un comprimido de XML: una edición de una celda reescribe casi todo el paquete, así que una comparación te dice que el archivo cambió y nada más. Dicho eso, la respuesta deja de importar después de la importación, porque el diagrama pasa a ser el maestro y su propio historial de revisiones toma el relevo. Mantener el CSV como copia paralela que la gente también edita reintroduce la divergencia que la conversión venía a terminar.
Mis columnas se desplazaron a mitad de la fila. ¿Qué ha pasado?
Casi siempre una coma sin entrecomillar dentro de un archivo delimitado por comas. La fila se parte por el delimitador antes de que nada mire los encabezados, así que una celda de Línea a que lleva 4,5 se lee como dos campos, la fila acaba con un campo más que el encabezado, y todas las columnas posteriores caen bajo el título de su vecina. Envuelve esas celdas en comillas dobles y el analizador las devuelve a su sitio. Lo mismo vale para Texto de línea y para cualquier etiqueta con una coma dentro, como el nombre de un producto. Si el desplazamiento empieza en la primerísima columna en lugar de en el medio, la causa es otra: el archivo va delimitado por punto y coma y se está leyendo como delimitado por comas, o hay una marca de orden de bytes pegada al primer nombre de encabezado y por eso ya no coincide.