Cómo crear un proceso de gestión de incidencias
Cómo diseñar un proceso de gestión de incidencias en el que la severidad dimensione todo lo posterior: clasificar antes de diagnosticar, dibujar la reclasificación como una vía y pasar la causa a un registro aparte.
Un proceso de gestión de incidencias restablece un servicio por una vía dimensionada según la severidad de la incidencia y, una vez recuperado el servicio, entrega la pregunta pendiente sobre la causa a un registro de problema aparte.
En resumen
- La prioridad se calcula a partir de los campos del registro, no de lo grave que parezca la incidencia.
- Un camino único para toda incidencia es demasiado pesado para las pequeñas y demasiado silencioso para las graves.
- Subir o bajar la severidad a mitad de incidencia necesita su propia vía dibujada, y casi ningún diagrama la tiene.
- Restablecer el servicio y explicarlo son dos procesos con un traspaso entre ambos.
- El cierre necesita la confirmación de quien reportó, no la confianza de quien arregló.
La severidad no es un campo, es el proceso entero
La gestión de incidencias restablece un servicio y después da cuenta de lo ocurrido. La versión que casi todas las organizaciones dibujan primero es un camino único (registrar, diagnosticar, arreglar, cerrar) y falla en las dos direcciones a la vez. Es demasiado ceremonioso para la impresora que nadie alcanza, así que la gente deja de abrir tickets y llama a un compañero, y es demasiado silencioso para la caída que debería haber despertado a tres personas.
La prioridad se fija a partir del impacto y la urgencia antes de que nadie sepa qué está roto, y todo lo posterior queda dimensionado por esa única decisión: a quién se llama, cada cuánto oyen algo los interesados y contra qué reloj se mide el arreglo. La clasificación es, por tanto, el paso que sostiene el edificio, y se toma con información parcial, así que alguna vez será errónea; eso significa que la reclasificación pertenece al mapa como una vía dibujada y no como una edición discreta de un campo.
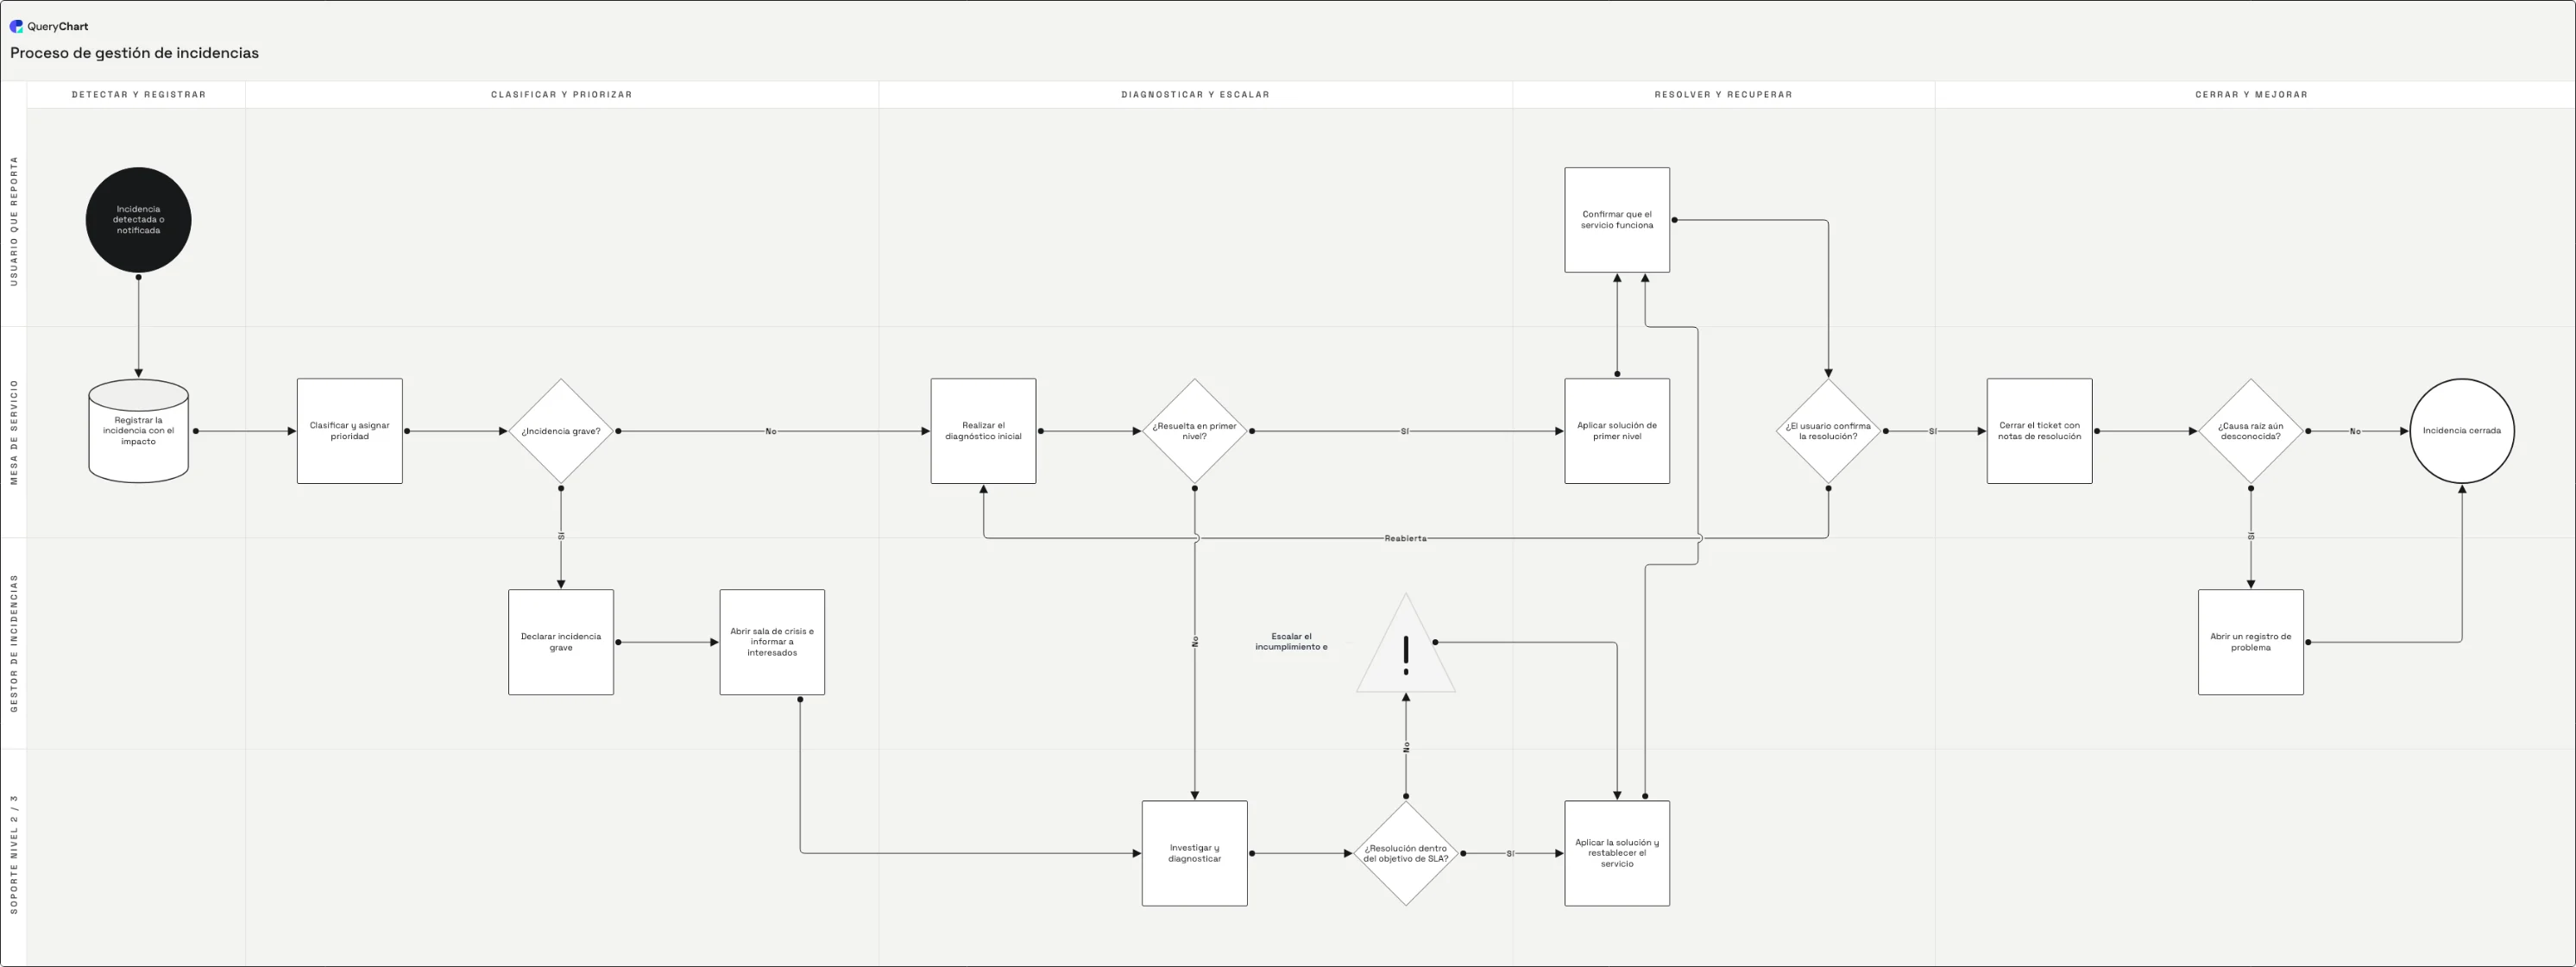
El ejemplo reparte una incidencia en cinco fases y cuatro carriles, y la fila que merece una mirada larga es «Investigar y diagnosticar»: una incidencia grave declarada y un ticket que el primer nivel no supo resolver aterrizan en la misma caja. La severidad decide a quién se llama y qué reloj corre, no quién acaba diagnosticando, y ese es el límite honesto de la proporcionalidad del diagrama. Fíjate también en que «¿Causa raíz aún desconocida?» se pregunta en un solo sitio para todas las severidades, y por eso una P1 y una P4 dejan tras de sí la misma evidencia.
Una decisión de severidad y todo lo que viene después
Fíjate en cuánto resuelve «¿Incidencia grave?» antes de que nadie diagnostique nada: una sala de crisis, un aviso a los interesados y un cambio de carril responsable.
Un ticket pobre es una prioridad errónea
La recepción son dos filas: «Incidencia detectada o notificada» y «Registrar la incidencia con el impacto». Todo aquello a partir de lo que se calcula la prioridad se captura en la segunda (servicio afectado, a cuánta gente afecta, cuándo empezó, los síntomas), así que un ticket pobre no retrasa la clasificación: la corrompe.
La severidad dimensiona lo que sigue
La salida «Sí» de «¿Incidencia grave?» no es una versión más ruidosa del mismo camino: «Declarar incidencia grave» y «Abrir sala de crisis e informar a interesados» ocurren antes de que nadie diagnostique nada, y la propiedad pasa del carril de mesa de servicio al de gestor de incidencias. La rama «No» llega a continuación.
Dos vías hasta el servicio restablecido
«¿Resuelta en primer nivel?» mantiene cortas las pequeñas: su salida «Sí» va a «Aplicar solución de primer nivel». El resto se suma al carril de soporte nivel 2 / 3, donde «¿Resolución dentro del objetivo de SLA?» se pregunta después del diagnóstico, de modo que «Escalar el incumplimiento e informar» reporta un incumplimiento que ya es tarde para evitar.
La reapertura se salta la clasificación
La salida «Reabierta» de «¿El usuario confirma la resolución?» reentra en «Realizar el diagnóstico inicial», que está por debajo de la decisión de severidad, así que una incidencia reabierta se vuelve a diagnosticar pero nunca se reclasifica, cueste lo que cueste ya ese segundo fallo. «Abrir un registro de problema» es por donde sale la causa.
Cómo funciona
Escribe la matriz de prioridad antes que el diagrama
La prioridad es el impacto contra la urgencia, y ambos necesitan niveles declarados: cuántos usuarios, qué nivel de servicio, si hay dinero o seguridad de por medio, con qué rapidez crece el daño, si aguanta una solución temporal. Acuerda eso primero, porque una matriz inventada mientras se dibuja el mapa describe la última incidencia y no la siguiente.
Decide qué cambia de verdad una incidencia grave
Enumera lo que compra la declaración: un responsable con nombre, una sala de crisis, actualizaciones a hora fija, permiso para saltarse la aprobación normal de cambios. Si no cambia nada salvo la etiqueta, la rama es decoración. El ejemplo le dedica dos pasos completos, que es la cantidad honesta de trabajo que hay detrás de ella.
Teclea la recepción y la clasificación como filas
Cada fila de QueryChart es una caja. Pon el disparador en la columna «Box text», después el paso de registro y después el de categorización, y apunta cada fila a la siguiente en la columna «Line to». A las tres filas el mapa ya ha hecho su argumento: la prioridad de la fila 3 se calcula a partir de lo que capturó la fila 2, lo que convierte a la fila 2 en una decisión de diseño y no en un formulario.
Bifurca la decisión de severidad y etiqueta ambas salidas
Cambia a Decision la columna «Shape» de la fila de clasificación, enumera los dos destinos en «Line to» y da después a cada número su respuesta en «Line text». El diagrama se bifurca una sola vez, en «¿Incidencia grave?», aunque la matriz tenga cuatro o cinco niveles, y esas dos etiquetas trabajan más que cualquier otro par de aquí, porque son el único sitio donde cambia la vía.
Apunta la vía de reapertura a un número de fila anterior
Un arreglo que quien reportó rechaza vuelve al diagnóstico: la salida «Reabierta» de la fila 15 apunta a la fila 7. Una severidad mal fijada necesita el mismo tratamiento y el ejemplo no lo dibuja: añade una rama desde las filas de diagnóstico de vuelta a «Clasificar y asignar prioridad». Cada una de ellas es un número menor en la columna «Line to».
Calibra la matriz y nombra después a quien declara
Pon la matriz donde pueda leerla quien registra el ticket y después pruébala: da a dos personas de turnos opuestos las mismas tres descripciones y compara lo que fijan. Que discrepen significa que falta un nivel, no que un compañero sea descuidado. Nombra después a la persona de cada turno que puede responder «Sí» en «¿Incidencia grave?» antes de que el gestor de incidencias esté despierto.
Errores que debes evitar
Clasificar después del diagnóstico
Para entonces el escalado que importaba no ha ocurrido, y el campo de prioridad solo registra lo mal que acabó saliendo. El impacto y la urgencia se pueden contestar antes que la causa, y por eso la fila de clasificación está en la posición tres.
La severidad con la que nació
El impacto crece; la prioridad no. Fijada una sola vez en el carril de mesa de servicio, deja atada la lista de llamadas y el reloj, y la única vía hacia atrás del diagrama reentra por debajo de ella. Dibuja la reclasificación como una vía y nombra a quién puede tomarla.
Reabrir levantando un ticket nuevo
El original se cierra dentro del objetivo, un segundo ticket arranca un reloj limpio y el informe muestra dos arreglos rápidos en lugar de uno fallido. Dibuja la reapertura como una vuelta al diagnóstico sobre el mismo registro.
Registros de problema sin responsable
«Abrir un registro de problema» es una fila, no un desenlace. Un registro sin responsable, sin fecha y sin enlace a las incidencias que lo produjeron es papeleo de cierre, y se cierra sin leer en la siguiente limpieza. Nombra ambas cosas al abrirlo.
Crea tu propio proceso de incidencias
Abre el ejemplo de incidencias como diagrama propio, pon tus umbrales de severidad en la fila de clasificación y tus roles de guardia en los carriles.
Guías relacionadas
Preguntas frecuentes
¿Cuál es la diferencia entre una incidencia y un problema?
Una incidencia es una interrupción de un servicio; un problema es la causa subyacente de una o varias incidencias. Se mantienen como procesos separados porque corren con relojes distintos: la gestión de incidencias se mide por el tiempo hasta restablecer y la gestión de problemas por si la causa se ha eliminado de verdad, algo que puede llevar semanas. Fundir las dos hace que el trabajo sobre la causa herede la urgencia de la incidencia y se abandone en el momento en que el servicio vuelve.
¿Cómo se decide la prioridad de una incidencia?
A partir del impacto y la urgencia sobre una matriz publicada, no a partir de quién pregunta. El impacto es cuánta organización queda afectada: usuarios, sedes, nivel de servicio, si hay dinero o seguridad de por medio. La urgencia es con qué rapidez crece el daño y si aguanta una solución temporal. La matriz convierte ese par en una prioridad, y solo se gana su sitio si las cifras que hay detrás de la decisión quedan registradas junto a ella: una prioridad que nadie puede reconstruir no se puede discutir cuando resulta estar equivocada.
¿Cuándo debe declararse una incidencia como grave?
Cuando cruza un umbral acordado de antemano: un servicio de primer nivel caído, un número declarado de personas sin poder trabajar, exposición regulatoria o de seguridad, una brecha sospechada. La declaración solo se gana su sitio si cambia comportamientos: un gestor de incidencias con nombre, una sala de crisis, actualizaciones con una cadencia fija. Declarar tarde es el fallo habitual, y el coste de declarar y después desconvocar es muchísimo menor que el coste de una hora de silencio.
¿Una incidencia reabierta debe ser un ticket nuevo?
No: reabre el original, porque los dos registros contestan preguntas distintas. Un ticket nuevo reinicia el reloj de resolución y reporta un arreglo fallido como dos arreglos con éxito, que es precisamente la distorsión que esconde un servicio inestable. Reabrir sobre el mismo registro mantiene el histórico en un solo sitio y hace medible la tasa de reapertura, y la tasa de reapertura es la señal de calidad más honesta que produce un proceso de incidencias.