So erstellen Sie einen Incident-Management-Prozess
So gestalten Sie einen Incident-Management-Prozess, in dem der Schweregrad alles Nachgelagerte dimensioniert: erst einstufen, dann diagnostizieren, Neueinstufung als Weg zeichnen, Ursache in einen eigenen Datensatz.
Ein Incident-Management-Prozess stellt einen Service auf einem Weg wieder her, der nach dem Schweregrad des Vorfalls bemessen ist, und gibt die offene Frage nach der Ursache an einen eigenen Problem-Datensatz ab, sobald der Service wieder läuft.
Kurz gesagt
- Die Priorität wird aus den Feldern der Erfassung berechnet, nicht daraus, wie schlimm sich der Vorfall anfühlt.
- Ein Pfad für alle Incidents ist für die kleinen zu schwer und für die ernsten zu leise.
- Den Schweregrad mitten im Vorfall zu heben oder zu senken braucht einen eigenen gezeichneten Weg, den die meisten Diagramme weglassen.
- Den Service wiederherzustellen und ihn zu erklären sind zwei Prozesse mit einer Übergabe dazwischen.
- Der Abschluss braucht die Bestätigung des Melders, nicht die Überzeugung der Technikerin.
Der Schweregrad ist kein Feld, er ist der Prozess
Incident Management stellt einen Service wieder her und legt danach Rechenschaft über das Geschehene ab. Die Fassung, die die meisten Organisationen zuerst zeichnen, ist ein einzelner Pfad (erfassen, diagnostizieren, beheben, schließen), und sie scheitert in beide Richtungen gleichzeitig. Für den Drucker, den niemand erreicht, ist sie zu schwerfällig, also melden die Leute keine Tickets mehr und rufen eine Kollegin an; und für den Ausfall, der drei Menschen hätte wecken müssen, ist sie viel zu leise.
Die Priorität wird aus Auswirkung und Dringlichkeit gesetzt, bevor jemand weiß, was kaputt ist, und alles danach ist von dieser einen Einschätzung bemessen: wer angerufen wird, wie oft Stakeholder von Ihnen hören, gegen welche Uhr die Behebung gemessen wird. Die Einstufung ist damit der tragende Schritt, und sie erfolgt auf unvollständiger Grundlage: sie wird also manchmal falsch sein, und das heißt, dass die Neueinstufung als gezeichneter Weg auf die Karte gehört und nicht als stille Änderung an einem Feld.
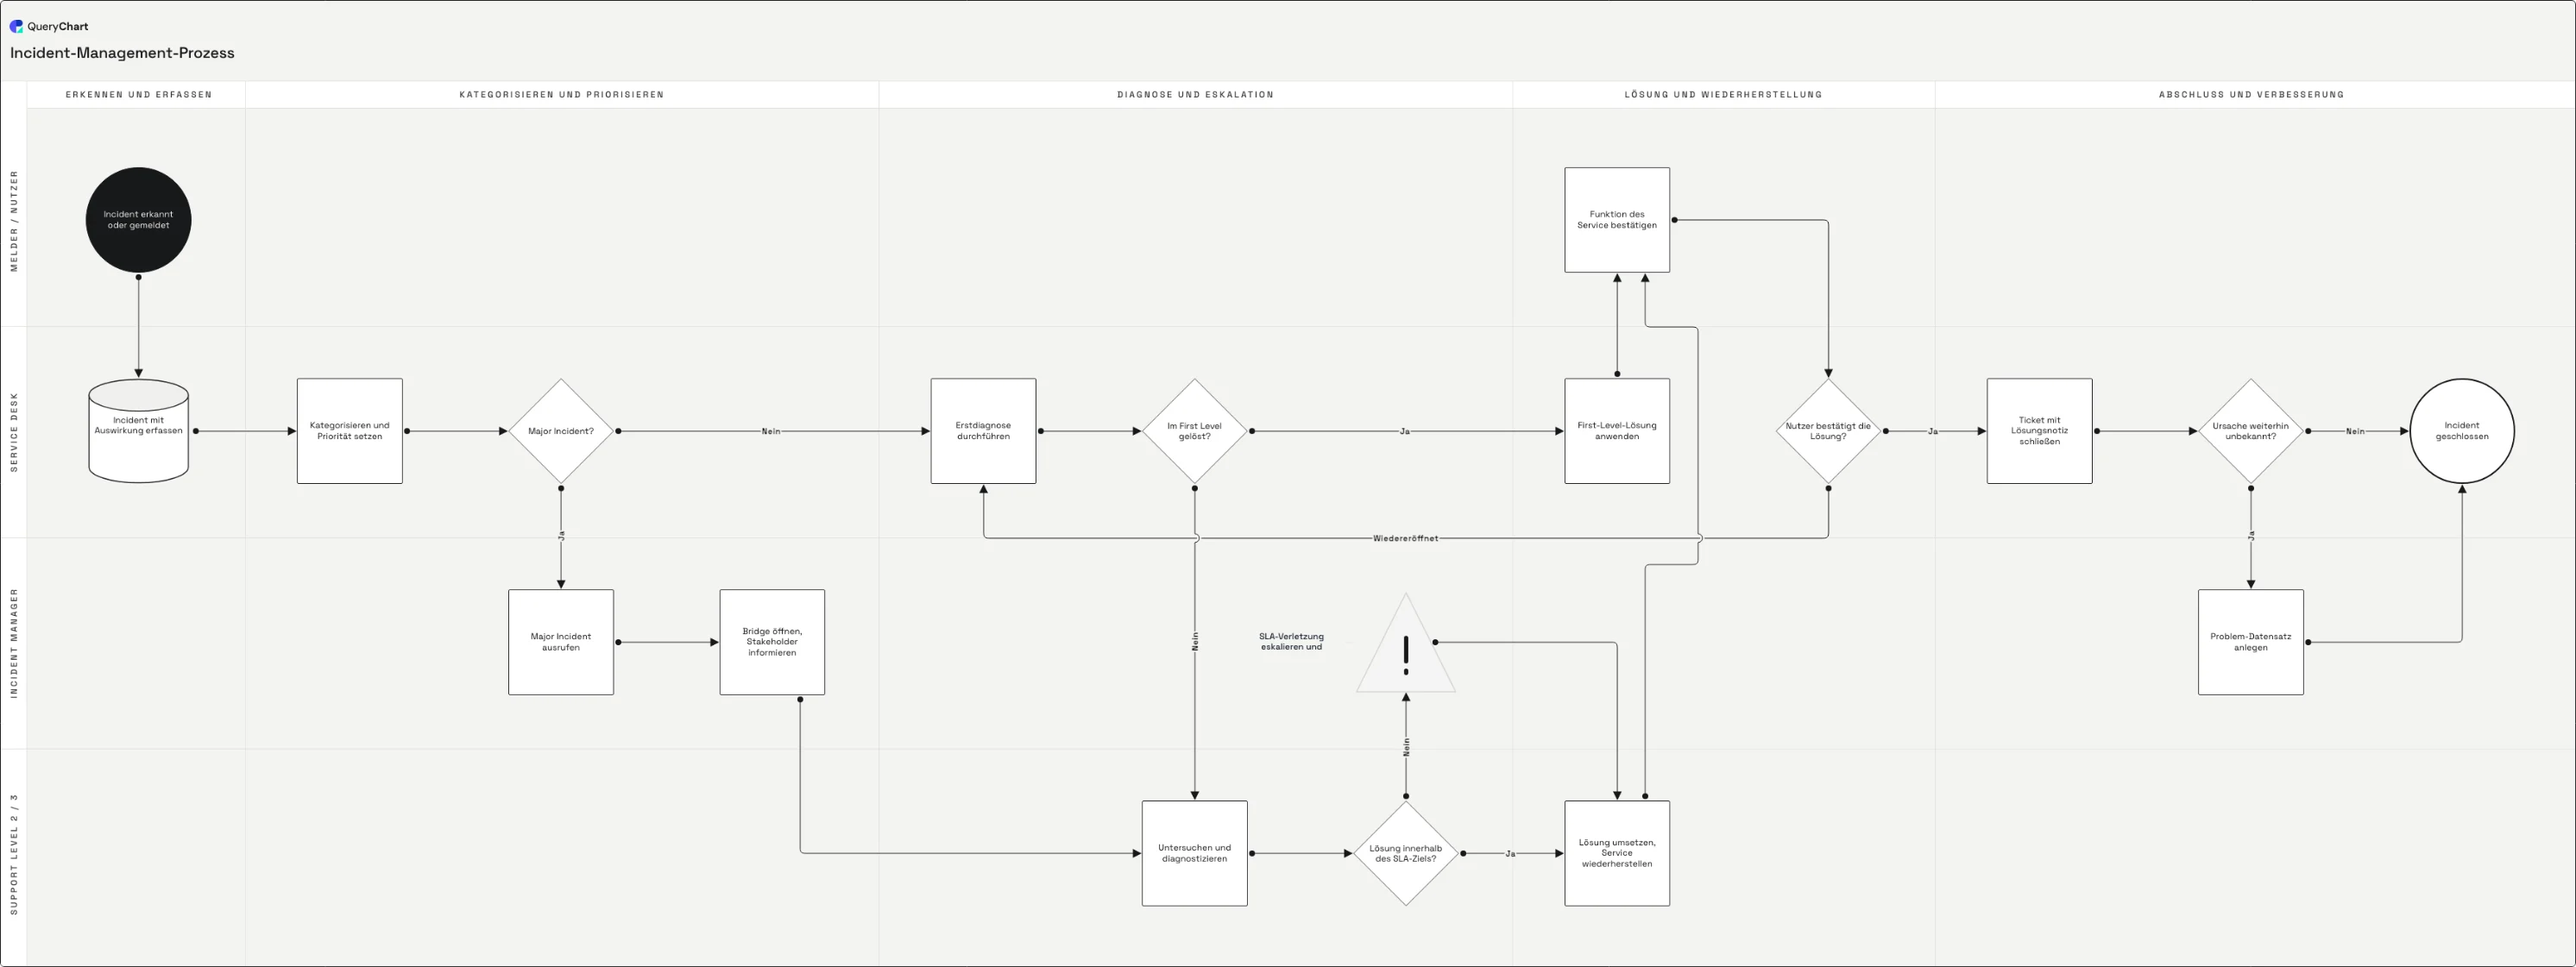
Das Beispiel führt einen Incident über fünf Phasen und vier Bahnen, und die Zeile, auf die es sich zu starren lohnt, ist „Untersuchen und diagnostizieren“: Ein ausgerufener Major Incident und ein Ticket, das der First Level nicht lösen konnte, landen im selben Kasten. Der Schweregrad entscheidet, wer gerufen wird und welche Uhr läuft, nicht, wer am Ende diagnostiziert: das ist die ehrliche Grenze der Verhältnismäßigkeit dieses Diagramms. Beachten Sie außerdem, dass „Ursache weiterhin unbekannt?“ für jeden Schweregrad an einer Stelle gefragt wird, weshalb ein P1 und ein P4 dieselben Nachweise hinterlassen.
Eine Schweregrad-Einschätzung, alles danach
Achten Sie darauf, wie viel „Major Incident?“ klärt, bevor überhaupt jemand diagnostiziert: eine Bridge, eine Stakeholder-Information und ein Wechsel der verantwortlichen Bahn.
Ein dünnes Ticket ist eine falsche Priorität
Die Erfassung besteht aus zwei Zeilen: „Incident erkannt oder gemeldet“ und „Incident mit Auswirkung erfassen“. Alles, woraus die Priorität berechnet wird, entsteht in der zweiten (betroffener Service, wie viele Menschen, seit wann, die Symptome); ein dünnes Ticket verzögert die Einstufung also nicht, es verfälscht sie.
Der Schweregrad bemisst das Folgende
Der Ja-Ausgang von „Major Incident?“ ist keine lautere Fassung desselben Pfades: „Major Incident ausrufen“ und „Bridge öffnen, Stakeholder informieren“ geschehen beide, bevor jemand diagnostiziert, und die Verantwortung wandert vom Service Desk in die Bahn Incident Manager. Der Nein-Arm folgt in der nächsten Stufe.
Zwei Wege zum wiederhergestellten Service
„Im First Level gelöst?“ hält die kleinen Fälle kurz: Der Ja-Ausgang führt zu „First-Level-Lösung anwenden“. Der Rest geht in die Bahn Support Level 2 / 3, wo „Lösung innerhalb des SLA-Ziels?“ erst nach der Diagnose gefragt wird: „SLA-Verletzung eskalieren und informieren“ meldet also eine Verletzung, die zu verhindern zu spät ist.
Die Wiedereröffnung überspringt die Einstufung
Der Ausgang „Wiedereröffnet“ von „Nutzer bestätigt die Lösung?“ tritt bei „Erstdiagnose durchführen“ wieder ein, und die sitzt unterhalb der Schweregrad-Einschätzung: ein wiedereröffneter Incident wird also erneut diagnostiziert, aber nie neu eingestuft, was auch immer der zweite Ausfall bis dahin gekostet hat. „Problem-Datensatz anlegen“ ist die Stelle, an der die Ursache den Prozess verlässt.
So funktioniert es
Schreiben Sie die Prioritätsmatrix vor dem Diagramm
Priorität ergibt sich aus Auswirkung und Dringlichkeit, und beide brauchen benannte Stufen: wie viele Nutzer, welche Serviceklasse, ob Geld oder Sicherheit im Spiel ist, wie schnell der Schaden wächst, ob ein Workaround trägt. Stimmen Sie das zuerst ab, denn eine beim Modellieren erfundene Matrix beschreibt den letzten Vorfall und nicht den nächsten.
Legen Sie fest, was ein Major Incident wirklich ändert
Listen Sie auf, was die Ausrufung einbringt: einen benannten Verantwortlichen, eine Bridge, Updates nach festem Takt, die Erlaubnis, die normale Änderungsfreigabe zu umgehen. Ändert sich nichts außer dem Etikett, ist der Zweig Dekoration. Das Beispiel verwendet zwei ganze Schritte darauf, und das ist der ehrliche Aufwand, der dahintersteckt.
Tippen Sie Erfassung und Einstufung als Zeilen
Jede Zeile in QueryChart ist ein Kasten. Tragen Sie den Auslöser in die Spalte Boxtext ein, dann den Erfassungsschritt, dann den Einstufungsschritt, und zeigen Sie mit jeder Zeile in der Spalte Linie zu auf die nächste. Nach drei Zeilen hat die Karte ihr Argument vorgebracht: Die Priorität in Zeile 3 wird aus dem berechnet, was Zeile 2 erfasst hat, und damit ist Zeile 2 eine Gestaltungsentscheidung und kein Formular.
Verzweigen Sie die Schweregrad-Frage und beschriften Sie beide Ausgänge
Ändern Sie die Spalte Form der Einstufungszeile auf Entscheidung, listen Sie beide Ziele in Linie zu und geben Sie dann jeder Nummer ihre Antwort im Linientext. Das Diagramm verzweigt einmal, bei „Major Incident?“, obwohl die Matrix vier oder fünf Stufen hat, und diese zwei Beschriftungen leisten mehr als jedes andere Paar hier, weil sie die einzige Stelle sind, an der sich der Weg ändert.
Richten Sie den Wiedereröffnungsweg auf eine kleinere Zeilennummer
Eine Behebung, die der Melder ablehnt, geht zurück in die Diagnose: Der Ausgang „Wiedereröffnet“ aus Zeile 15 zeigt auf Zeile 7. Ein falsch gesetzter Schweregrad braucht dieselbe Behandlung, und das Beispiel zeichnet sie nicht: ergänzen Sie einen Zweig von den Diagnosezeilen zurück zu „Kategorisieren und Priorität setzen“. Jeder davon ist eine kleinere Nummer in der Spalte Linie zu.
Kalibrieren Sie die Matrix und benennen Sie, wer ausruft
Legen Sie die Matrix dorthin, wo die Person, die das Ticket erfasst, sie lesen kann, und testen Sie sie: Geben Sie zwei Personen aus verschiedenen Schichten dieselben drei Beschreibungen und vergleichen Sie, was sie setzen. Uneinigkeit heißt fehlende Stufe, nicht unaufmerksame Kollegin. Benennen Sie dann pro Schicht die Person, die bei „Major Incident?“ mit Ja antworten darf, bevor der Incident Manager wach ist.
Häufige Fehler
Einstufung nach der Diagnose
Bis dahin ist die Eskalation, auf die es ankam, nicht erfolgt, und das Prioritätsfeld hält nur fest, wie schlimm es ausgegangen ist. Auswirkung und Dringlichkeit sind vor der Ursache beantwortbar: deshalb sitzt die Einstufungszeile an dritter Stelle.
Der Schweregrad, mit dem das Ticket geboren wurde
Die Auswirkung wächst, die Priorität nicht. Einmal in der Bahn Service Desk gesetzt, legt sie Anrufliste und Uhr fest, und der einzige Rückweg des Diagramms tritt darunter wieder ein. Zeichnen Sie die Neueinstufung als Weg und benennen Sie, wer ihn gehen darf.
Wiedereröffnen durch ein neues Ticket
Das ursprüngliche wird innerhalb der Zielzeit geschlossen, ein zweites Ticket startet die Uhr neu, und die Auswertung zeigt zwei schnelle Behebungen statt einer gescheiterten. Zeichnen Sie die Wiedereröffnung als Rückkehr in die Diagnose auf demselben Datensatz.
Problem-Datensätze ohne Verantwortlichen
„Problem-Datensatz anlegen“ ist eine Zeile, kein Ergebnis. Ein Datensatz ohne Verantwortlichen, ohne Datum und ohne Verweis zurück auf die Incidents, die ihn erzeugt haben, ist Abschlusspapier und wird beim nächsten Aufräumen ungelesen geschlossen. Benennen Sie beides beim Anlegen.
Eigenen Incident-Prozess erstellen
Öffnen Sie das Incident-Beispiel als eigenes Diagramm, tragen Sie Ihre Schwellen für den Schweregrad in die Einstufungszeile ein und setzen Sie Ihre Rufbereitschaftsrollen in die Bahnen.
Verwandte Anleitungen
Häufig gestellte Fragen
Was ist der Unterschied zwischen Incident und Problem?
Ein Incident ist eine Unterbrechung eines Service; ein Problem ist die zugrunde liegende Ursache eines oder mehrerer Incidents. Sie werden als getrennte Prozesse geführt, weil sie auf unterschiedlichen Uhren laufen: Incident Management wird an der Zeit bis zur Wiederherstellung gemessen, Problem Management daran, ob die Ursache tatsächlich beseitigt wurde, und das kann Wochen dauern. Beides zu verschmelzen bedeutet, dass die Ursachenarbeit die Dringlichkeit des Incidents erbt und in dem Moment abgebrochen wird, in dem der Service zurück ist.
Wie wird die Priorität eines Incidents bestimmt?
Aus Auswirkung und Dringlichkeit nach einer veröffentlichten Matrix, nicht danach, wer fragt. Auswirkung ist, wie viel der Organisation betroffen ist: Nutzer, Standorte, Serviceklasse, ob Geld oder Sicherheit im Spiel ist. Dringlichkeit ist, wie schnell der Schaden wächst und ob ein Workaround trägt. Die Matrix macht aus diesem Paar eine Priorität, und sie verdient ihren Platz nur, wenn die Zahlen hinter der Einschätzung mit festgehalten werden: eine Priorität, die niemand nachvollziehen kann, lässt sich nicht bestreiten, wenn sie sich als falsch erweist.
Wann wird ein Vorfall zum Major Incident erklärt?
Wenn er eine vorab abgestimmte Schwelle überschreitet: ein Service der höchsten Klasse ausgefallen, eine festgelegte Zahl arbeitsunfähiger Personen, regulatorische oder sicherheitsrelevante Betroffenheit, ein vermuteter Datenschutzvorfall. Die Ausrufung verdient ihren Platz nur, wenn sie Verhalten ändert: ein benannter Incident Manager, eine Bridge, Updates in festem Takt. Zu spät auszurufen ist der verbreitete Fehler, und die Kosten des Ausrufens mit anschließender Entwarnung liegen weit unter den Kosten einer stillen Stunde.
Sollte ein wiedereröffneter Incident ein neues Ticket sein?
Nein: eröffnen Sie das ursprüngliche wieder, denn die beiden Datensätze beantworten verschiedene Fragen. Ein neues Ticket setzt die Lösungsuhr zurück und meldet eine gescheiterte Behebung als zwei erfolgreiche, und genau diese Verzerrung verbirgt einen instabilen Service. Auf demselben Datensatz wiederzueröffnen hält die Historie an einer Stelle und macht die Wiedereröffnungsrate messbar, und die Wiedereröffnungsrate ist das ehrlichste Qualitätssignal, das ein Incident-Prozess erzeugt.